
Для нейросетей видеокарту выбирают в первую очередь по объёму памяти: на 12 ГБ запускаются небольшие языковые модели, на 16 ГБ модели крупнее, а 24 и 32 ГБ нужны, чтобы не выгружать часть модели в оперативную память. Мы собрали 10 карт NVIDIA, AMD и Intel из розницы и разделили их на три группы по объёму памяти.
- Три группы карт: 12, 16 и 24-32 ГБ
- Где работает CUDA, а где ROCm
- Что важнее для нейросети: объём или скорость памяти
- Термины, выбор и ответы на частые вопросы
Для игр смотрите рейтинг игровых видеокарт, а если интересует выбор фирмы, то рейтинг производителей видеокарт.
Рейтинг лучших видеокарт для нейросетей
Видеокарты на 12 ГБ для входа в тему
Карты на 12 ГБ годятся для первых экспериментов: запуск небольших языковых моделей в сжатом виде и генерация изображений. Различаются они не столько объёмом, сколько скоростью памяти и программной поддержкой: от 360 ГБ/с у RTX 3060 до 672 ГБ/с у RTX 5070.
NVIDIA GeForce RTX 5070 12GB
 Маркет Яндекс |
RUB 85 942,00 | В магазин |
Главное в этой карте сочетание двух параметров: 12 ГБ памяти и пропускная способность 672 ГБ/с. Объём определяет, какого размера модель поместится в видеопамять: для языковых моделей на 7-8 млрд параметров в сжатом виде этого хватает с запасом под контекст, а модели крупнее придётся частично выгружать в оперативную память. Скорость памяти влияет на то, как быстро модель выдаёт текст, и среди карт на 12 ГБ у RTX 5070 она самая высокая.
Тензорные ядра 5-го поколения и CUDA открывают доступ к программам, которые в первую очередь пишут под NVIDIA. Энергопотребление 250 Вт и блок питания от 650 Вт позволяют собрать систему в обычном корпусе. Платой за скорость стал ограниченный объём: 12 ГБ воспринимаются скромно, и для генерации крупных изображений или длинного контекста этот запас быстро расходуется.
- Память 672 ГБ/с, самая высокая в категории
- 192 тензорных ядра 5-го поколения, заявлено 988 AI TOPS
- Поддержка CUDA
- Умеренные 250 Вт и блок питания от 650 Вт
- Всего 12 ГБ видеопамяти: крупные модели не помещаются целиком
- Вентиляторы шумят заметнее, чем у соседних моделей, по обзору Notebookcheck
- Для питания нужен переходник с двух 8-pin или кабель PCIe Gen 5
NVIDIA GeForce RTX 3060 12GB
|
Маркет Яндекс
|
RUB 51 489,00 | В магазин |
Карта 2021 года остаётся входным билетом в локальные нейросети из-за сочетания 12 ГБ памяти и CUDA. Объём у неё такой же, как у RTX 5070, поэтому по размеру помещающихся моделей они равны, а вот пропускная способность 360 ГБ/с почти вдвое ниже, чем у RTX 5070. Для языковых моделей это означает более медленную генерацию текста при том же размере модели.
Энергопотребление 170 Вт, один 8-контактный разъём и блок питания от 550 Вт подходят для скромного компьютера без замены блока питания. Тензорные ядра 3-го поколения и CUDA совместимы с привычными для нейросетей библиотеками, но по скорости матричных вычислений карта уступает новым поколениям.
- 12 ГБ видеопамяти при 170 Вт
- Один 8-контактный разъём питания
- Тензорные ядра 3-го поколения и CUDA
- Интерфейс PCIe 4.0 x16
- Пропускная способность 360 ГБ/с заметно ниже, чем у новых карт
- Тензорные ядра прошлого поколения, медленнее, чем у Blackwell
Intel Arc B580 12GB
|
Маркет Яндекс
|
RUB 42 999,00 | В магазин |
Arc B580 предлагает 12 ГБ GDDR6 с пропускной способностью 456 ГБ/с, а это больше, чем у RTX 3060 при том же объёме. Для задач ИИ в карте есть 160 XMX-движков архитектуры Xe2, которые выполняют матричные вычисления. Программная часть при этом иная: CUDA здесь нет, поэтому перед покупкой стоит проверить, поддерживает ли нужная программа видеокарты Intel.
Один 8-контактный разъём, энергопотребление 190 Вт и интерфейс PCIe 4.0 x8 не требуют особой подготовки корпуса. Но по данным TechSpot, производительность сильно зависит от мощности процессора из-за накладных расходов драйвера, поэтому со слабым процессором потенциал карты раскрывается не полностью.
- 12 ГБ видеопамяти и 456 ГБ/с
- 160 XMX-движков для матричных вычислений
- Один 8-контактный разъём питания
- Лучшая стоимость кадра среди конкурентов по оценке TechSpot
- Производительность сильно зависит от мощности процессора
- Потребляет примерно на 50 Вт больше, чем RTX 4060
- Экосистема ИИ-программ вокруг CUDA шире, чем вокруг видеокарт Intel
Видеокарты на 16 ГБ: оптимум для большинства задач
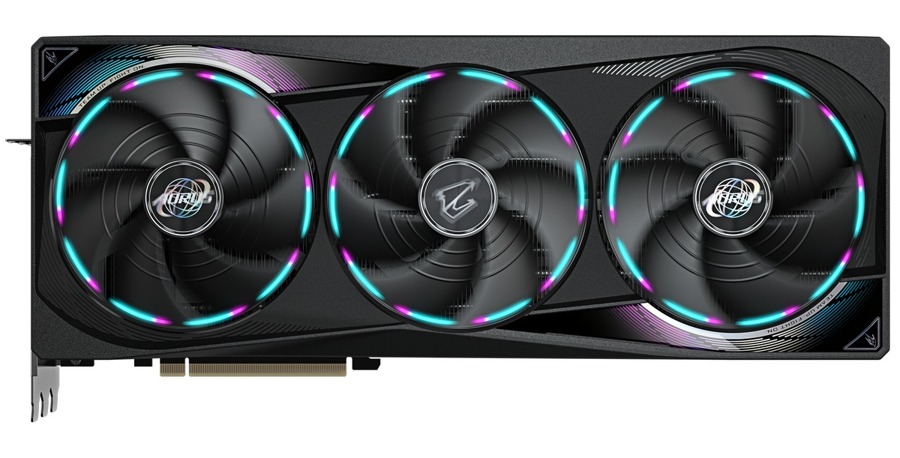
16 ГБ позволяют запускать модели крупнее, чем помещаются в 12 ГБ, и это самая массовая категория. Здесь важно смотреть на скорость памяти: от 320 ГБ/с у RX 9060 XT до 960 ГБ/с у RTX 5080 при одинаковом объёме.
NVIDIA GeForce RTX 5060 Ti 16GB
|
Маркет Яндекс
|
RUB 90 774,00 | В магазин |
16 ГБ видеопамяти при энергопотреблении 180 Вт: это главный довод в пользу карты. Такого объёма достаточно, чтобы запускать модели крупнее, чем помещаются в 12 ГБ, например языковые модели на 13-14 млрд параметров в сжатом виде, и работать с более тяжёлыми моделями генерации изображений. Один 8-контактный разъём и блок питания от 600 Вт делают сборку несложной.
Память GDDR7 даёт 448 ГБ/с, а у RTX 4060 Ti 16GB этот показатель был 288 ГБ/с. Заявленные 759 AI TOPS обеспечивают 144 тензорных ядра 5-го поколения. Ограничения вытекают из 128-битной шины: она ставит скорость памяти ниже, чем у RTX 5070 Ti, а интерфейс PCIe 5.0 x8 на старых платформах работает на более узком канале.
- 16 ГБ GDDR7 при 180 Вт
- 144 тензорных ядра 5-го поколения, заявлено 759 AI TOPS
- Память 448 ГБ/с против 288 ГБ/с у RTX 4060 Ti 16GB
- Один 8-контактный разъём питания
- Шина 128 бит ограничивает скорость памяти по сравнению с RTX 5070 и RTX 5070 Ti
- Интерфейс x8: на старых платформах канал к процессору уже
NVIDIA GeForce RTX 5070 Ti 16GB
|
Маркет Яндекс
|
RUB 137 957,00 | В магазин |
У RTX 5070 Ti тот же объём 16 ГБ, что и у RTX 5060 Ti, но память вдвое быстрее: 256 бит и 896 ГБ/с против 448 ГБ/с. Для языковых моделей это означает более быструю генерацию текста, а размер модели по-прежнему ограничен 16 ГБ. NVIDIA заявляет 1406 AI TOPS, у карты 8960 ядер CUDA и тензорные ядра 5-го поколения.
Платой за скорость стали габариты и питание: энергопотребление 300 Вт, блок питания от 750 Вт и разъём 16-pin (переходник с двух 8-pin входит в комплект). Founders Edition для этой модели нет, а партнёрские карты, по обзору TechRadar, объёмные, поэтому под компактный корпус придётся подбирать версию отдельно.
- 16 ГБ GDDR7 на 256-битной шине, 896 ГБ/с
- Тензорные ядра 5-го поколения, заявлено 1406 AI TOPS
- Энергопотребление до 300 Вт, ниже, чем у карт старшего класса
- Поддержка PCIe 5.0
- Для крупных моделей 16 ГБ памяти мало
- Партнёрские версии громоздкие, для компактных корпусов неудобны
- Нужен разъём 16-pin или переходник с двух 8-pin
NVIDIA GeForce RTX 5080 16GB
|
Маркет Яндекс
|
RUB 194 000,00 | В магазин |
У RTX 5080 тот же объём 16 ГБ, что и у RTX 5070 Ti, но память быстрее: 256 бит и 960 ГБ/с против 896 ГБ/с. NVIDIA заявляет 1801 AI TOPS при 10752 ядрах CUDA, а тензорные ядра 5-го поколения умеют работать с форматом FP4. Для языковых моделей это означает более быструю генерацию текста, но размер модели по-прежнему ограничен 16 ГБ.
Главное ограничение для нейросетей как раз объём: по обзору Tom’s Hardware, 16 ГБ может не хватить для многих моделей, а прирост к предыдущему поколению скромный. Энергопотребление 360 Вт, блок питания нужен от 850 Вт, а партнёрские версии с тремя вентиляторами объёмные, поэтому длину и толщину карты стоит проверить до покупки.
- 16 ГБ GDDR7 на 256-битной шине, 960 ГБ/с
- Тензорные ядра 5-го поколения, заявлено 1801 AI TOPS, поддержка FP4
- Работает с CUDA
- Поддержка PCIe 5.0
- Для крупных моделей 16 ГБ памяти мало
- Энергопотребление 360 Вт, блок питания нужен от 850 Вт
- Прирост к предыдущему поколению скромный
- Партнёрские версии с тремя вентиляторами объёмные
AMD Radeon RX 9070 XT 16GB
|
Маркет Яндекс
|
RUB 96 273,00 | В магазин |
Память 16 ГБ GDDR6 на 256-битной шине (640 ГБ/с) ставит RX 9070 XT рядом с RTX 5070 Ti по объёму моделей, которые помещаются целиком. В карте 128 ИИ-ускорителей (389 TOPS INT8), а формат FP8 поддерживается только на архитектуре RDNA 4. Главная особенность: RX 9070 XT входит в список поддерживаемых ROCm и работает на Linux и на Windows 11, хотя AMD оговаривает, что на Windows весь стек ROCm поддержан не полностью.
Энергопотребление 304 Вт, блок питания от 750 Вт и два 8-контактных разъёма требуют запаса по питанию. По замерам Guru3D на ASUS TUF OC карта держится около 50 °C при 33-36 дБА, но в пике потребляет около 325 Вт, а при высокой частоте кадров в открытом корпусе слышен коильвайн.
- 16 ГБ памяти и 640 ГБ/с
- 128 ИИ-ускорителей на архитектуре RDNA 4
- Официальная поддержка ROCm на Linux и Windows 11
- Тихая и прохладная по замерам Guru3D
- Потребление в пике около 325 Вт
- Слышен коильвайн на высокой частоте кадров в открытом корпусе
- Список поддерживаемых дистрибутивов Linux для ROCm ограничен, на Windows поддержка неполная
AMD Radeon RX 9060 XT 16GB
|
Маркет Яндекс
|
RUB 74 545,00 | В магазин |
Самый скромный по питанию вариант с 16 ГБ: энергопотребление 160 Вт, блок питания от 450 Вт и один 8-контактный разъём. Память GDDR6 на 128-битной шине даёт 320 ГБ/с, меньше, чем у RTX 5060 Ti 16GB (448 ГБ/с), поэтому языковая модель того же размера будет выдавать текст медленнее. Объём моделей, которые помещаются целиком, у двух карт одинаков.
В пользу карты работает поддержка ROCm 7.2.1 на Linux и 64 ИИ-ускорителя на архитектуре RDNA 4. Для работы с ИИ на Linux это рабочий вариант, но выбор программ шире у NVIDIA.
- 16 ГБ видеопамяти при 160 Вт
- Блок питания от 450 Вт и один 8-контактный разъём
- Официальная поддержка ROCm в Linux
- 64 ИИ-ускорителя на архитектуре RDNA 4
- Память GDDR6 на 128 бит: 320 ГБ/с, ниже, чем у RTX 5060 Ti 16GB
- Поддержка ROCm подтверждена для ограниченного списка дистрибутивов Linux
Видеокарты на 24-32 ГБ для крупных моделей
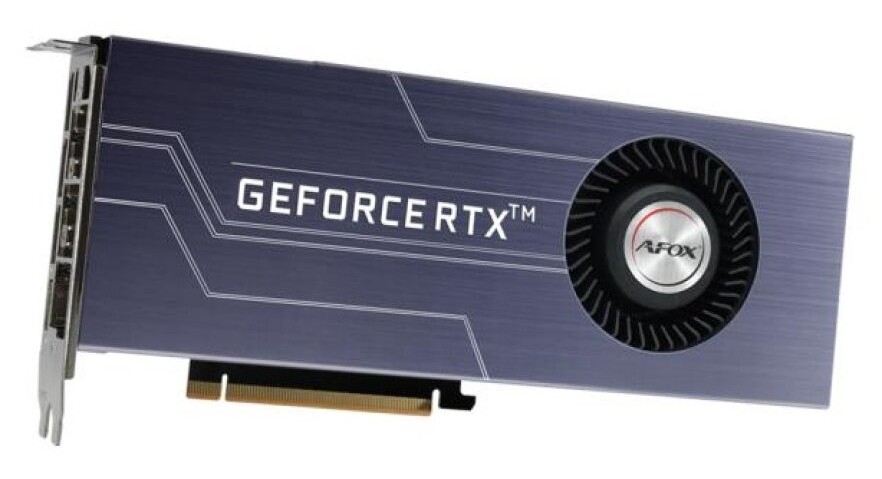
Карты с 24 и 32 ГБ нужны, когда модель не помещается в 16 ГБ и не хочется выгружать часть слоёв в оперативную память. Платой становятся энергопотребление до 350 Вт и габариты, а выбор между картами идёт по скорости памяти и программной поддержке.
AMD Radeon AI PRO R9700 32GB
|
Маркет Яндекс
|
RUB 320 404,00 | В магазин |
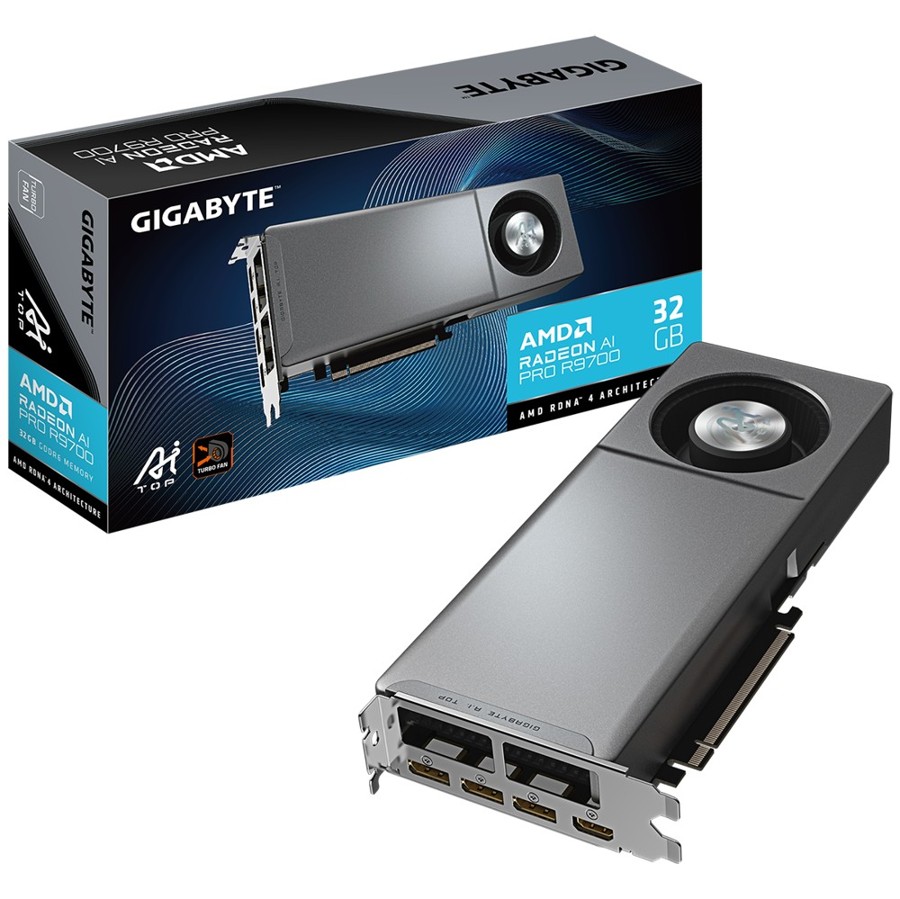
32 ГБ GDDR6 при энергопотреблении 300 Вт позволяют запускать модели, которые не помещаются в 24 ГБ. AMD заявляет 383 TOPS INT8 и 191 TFLOPS FP16 matrix (383 со sparsity). Двухслотовая турбина выдувает воздух из корпуса, что удобно для плотных сборок с несколькими картами. Карта входит в список поддерживаемых ROCm, а Phoronix на ROCm 7.0.2 под Ubuntu 24.04.3 назвал опыт очень гладким.
Ограничения связаны с памятью и платформой: 256-битная шина и 640 ГБ/с ниже, чем у RTX 3090 (936 ГБ/с), поэтому скорость генерации текста скромнее. ECC на уровне драйвера включается только под Linux, видеовыходы только DisplayPort, а полный стек ROCm на Windows пока не поддержан.
- 32 ГБ памяти при 300 Вт
- Двухслотовая турбина выдувает воздух из корпуса
- Официальная поддержка ROCm, по Phoronix очень гладкий опыт
- Память с ECC (на Linux)
- Скорость памяти 640 ГБ/с ниже, чем у RTX 3090
- ECC включён на уровне драйвера только под Linux
- Только DisplayPort, без HDMI
NVIDIA GeForce RTX 3090 24GB
|
Маркет Яндекс
|
RUB 259 564,00 | В магазин |
24 ГБ GDDR6X на 384-битной шине и 936,2 ГБ/с: по объёму и скорости памяти карта прошлого поколения опережает новые 16-гигабайтные модели и позволяет запускать более крупные модели без выгрузки в оперативную память. В продаже встречается версия Afox с турбинным кулером. Тензорные ядра 3-го поколения (328 штук) и CUDA совместимы с привычными для нейросетей библиотеками.
Платой за объём стали энергопотребление и габариты: 350 Вт (в тестах до 360 Вт), блок питания от 750 Вт и разъём 12-pin у референса. У Founders Edition трёхслотовая конструкция, по Tom’s Hardware, в большинство корпусов больше двух карт не помещается.
- 24 ГБ GDDR6X на 384-битной шине
- 936,2 ГБ/с пропускной способности
- Тензорные ядра и CUDA
- Мощное охлаждение, по Tom’s Hardware, тихо работает под нагрузкой
- Высокое энергопотребление: 350 Вт, в тестах до 360 Вт
- Громоздкая трёхслотовая конструкция референса: сложно ставить несколько карт
- Старое поколение: Ampere, PCIe 4.0, тензорные ядра 3-го поколения
Термины, которые встречаются в характеристиках
VRAM (видеопамять)
Память самой видеокарты. Языковая или графическая модель должна поместиться в неё целиком, иначе часть данных уходит в оперативную память, и работа замедляется.
Пропускная способность памяти
Сколько данных в секунду карта читает из своей памяти. От неё зависит скорость генерации текста языковой моделью: чем выше показатель, тем быстрее идут токены.
CUDA
Программная платформа NVIDIA для вычислений на видеокартах. На неё рассчитано большинство программ и библиотек для нейросетей.
ROCm
Аналогичная платформа AMD. Официально поддерживается на ряде дистрибутивов Linux, а на Windows 11 стек поддержан не полностью.
Тензорные ядра и ИИ-ускорители
Блоки видеокарты для матричных вычислений, на которых строятся нейросети. У NVIDIA это тензорные ядра, у AMD ИИ-ускорители, у Intel XMX-движки.
Квантизация
Сжатие весов модели до меньшей разрядности, например до 4 бит. Модель занимает меньше памяти ценой небольшой потери точности.
Инференс и обучение
Инференс это запуск готовой модели, обучение это настройка её весов. Обучение требует заметно больше памяти, чем запуск.
Как выбрать видеокарту для нейросетей
Начинайте с размера модели, которую собираетесь запускать: именно память определяет, поместится ли она целиком.
При одинаковом объёме быстрее генерирует текст карта с более широкой шиной и более высокой пропускной способностью.
У NVIDIA выбор программ шире за счёт CUDA. У AMD есть ROCm, он официально работает на Linux и частично на Windows 11. У Intel набор программ уже, и перед покупкой нужно проверить поддержку нужного ПО.
Карты на 24 и 32 ГБ требуют запаса по питанию и габаритов. Подобрать блок можно по рейтингу блоков питания.
Две карты складывают память, только если программа умеет распределять модель между ними. В плотном корпусе помогают турбинные кулеры, которые выдувают воздух наружу.
Модели вроде Tesla P40 дают много памяти, но рассчитаны на серверный воздушный поток, обычно без видеовыхода и без собственных вентиляторов.
Тем, кто собирает компьютер под нейросети, пригодится ещё и рейтинг корпусов для ПК: места под крупные карты нужно больше, чем кажется.
Частые вопросы о видеокартах для нейросетей
Сколько видеопамяти нужно для нейросетей?
Для первых экспериментов хватает 12 ГБ: небольшие языковые модели в сжатом виде и генерация изображений. 16 ГБ даёт запас под модели крупнее и более тяжёлые модели изображений. 24 и 32 ГБ нужны для больших моделей без выгрузки части слоёв в оперативную память.
Какие нейросети можно запустить на видеокарте локально?
Для текста подойдут языковые модели Qwen, Llama, Mistral, Gemma и DeepSeek в сжатом виде: их запускают через Ollama, LM Studio или llama.cpp. Для картинок используют Stable Diffusion (SD 1.5, SDXL, SD 3.5) и FLUX через ComfyUI или Automatic1111, для распознавания речи Whisper, для видео небольшие модели вроде Wan.
Размер модели зависит от объёма памяти. На 12 ГБ комфортно идут Qwen и Llama на 7-8 млрд параметров и Stable Diffusion XL, на 16 ГБ модели на 14 млрд параметров и FLUX в сжатом виде, на 24 и 32 ГБ модели на 30 млрд параметров и больше без выгрузки части слоёв в оперативную память.
Что лучше для нейросетей: NVIDIA или AMD?
У NVIDIA выбор программ шире, потому что большинство библиотек рассчитано на CUDA. AMD работает через ROCm, который официально поддержан на ряде дистрибутивов Linux и частично на Windows 11. Если нужна максимальная совместимость, берите NVIDIA, если важны объём памяти на единицу мощности и Linux, стоит смотреть AMD.
Хватит ли 8 ГБ видеопамяти для нейросетей?
Для небольших моделей в сжатом виде можно запускаться, но запаса по размеру модели и по контексту почти нет. В рейтинг карты на 8 ГБ не вошли: минимальный комфортный объём для нейросетей составляет 12 ГБ.
Какая видеокарта на 24 ГБ подойдёт?
В рейтинге это RTX 3090: 24 ГБ GDDR6X и 936 ГБ/с памяти. На 32 ГБ подходит Radeon AI PRO R9700.
Можно ли поставить две видеокарты в один компьютер?
Можно, но память двух карт складывается только в программах, которые умеют распределять модель между ними. Для плотных сборок удобны двухслотовые карты с турбинным охлаждением, например Radeon AI PRO R9700.
Нужна ли серверная H100 или A100 для дома?
Нет. Эти ускорители рассчитаны на дата-центры, стоят на порядок дороже игровых карт и в розницу почти не продаются. Для домашних задач хватает карт из рейтинга.
Нужны ли тензорные ядра для нейросетей?
Они ускоряют матричные вычисления, на которых строятся нейросети. У NVIDIA это тензорные ядра, у AMD ИИ-ускорители, у Intel XMX-движки. Карты без таких блоков тоже запускают нейросети, но медленнее.
Заключение
- 12 ГБ: RTX 5070 для скорости памяти, RTX 3060 для самого доступного входа в CUDA
- 16 ГБ: RTX 5060 Ti 16GB как лучший выбор по памяти и энергопотреблению, RTX 5080 по скорости памяти
- 24-32 ГБ: Radeon AI PRO R9700 по объёму на единицу мощности, RTX 3090 как карта с CUDA и 24 ГБ
Начинайте с объёма памяти и проверьте, поддерживает ли нужная программа вашу видеокарту. Если нейросети нужны не только для работы, но и для игр, загляните в рейтинг бюджетных видеокарт.
Добавить комментарий